Chroma hay Qdrant: chọn vector database nào cho prototype RAG self-hosted?
Khi doanh nghiệp muốn xây chatbot hỏi đáp tài liệu, câu hỏi đầu tiên thường là chọn model nào. Nhưng sau vài ngày thử nghiệm, một quyết định khác bắt đầu ảnh hưởng trực tiếp đến chất lượng và chi phí: chọn vector database nào để lưu embedding và tìm các đoạn tài liệu liên quan? Chroma và Qdrant đều là lựa chọn phổ biến trong hệ sinh thái RAG self-hosted, nhưng chúng phù hợp với những giai đoạn và yêu cầu khác nhau.
Bài viết này không xem hai công cụ như một cuộc thi tính năng. Mục tiêu là giúp chủ doanh nghiệp nhỏ, đội automation và agency trả lời thực tế: prototype nào nên làm nhanh bằng Chroma, khi nào nên chuyển sang Qdrant, và làm sao kết nối lớp tìm kiếm với n8n, NocoDB, Smax.AI, WordPress, website, Messenger hoặc Zalo.
Vector database nằm ở đâu trong hệ thống RAG?
Trong một hệ thống RAG, tài liệu được chia thành các đoạn nhỏ, sau đó embedding model biến mỗi đoạn thành một vector số. Vector database lưu vector cùng metadata như tên tài liệu, phòng ban, phiên bản, quyền truy cập và ngày cập nhật. Khi người dùng hỏi, hệ thống cũng biến câu hỏi thành vector, tìm các đoạn gần nhất rồi đưa chúng vào prompt để LLM tạo câu trả lời.
Vector database không thay thế kho file gốc, CRM hay hệ thống phân quyền. Nó là lớp chỉ mục phục vụ truy hồi. Vì vậy, kiến trúc tốt thường giữ file gốc ở object storage hoặc WordPress, lưu trạng thái xử lý ở NocoDB, còn Chroma hoặc Qdrant chỉ giữ dữ liệu cần cho tìm kiếm. Tách vai trò như vậy giúp dễ re-index khi đổi embedding model và dễ xoá dữ liệu theo yêu cầu.
Chroma là gì?
Chroma là một vector database tập trung vào trải nghiệm phát triển ứng dụng AI và RAG. Nó có API dễ tiếp cận, phù hợp để lập trình viên tạo collection, thêm documents hoặc embeddings, gắn metadata và thực hiện truy vấn similarity. Chroma thường xuất hiện trong notebook, ứng dụng Python/JavaScript và các prototype cần có kết quả nhanh mà chưa muốn dựng một cụm hạ tầng phức tạp.
Điểm mạnh của Chroma là đường cong học tập thấp. Một đội có thể bắt đầu bằng persistent storage trên máy local, sau đó đóng gói cùng ứng dụng bằng Docker. Với chatbot nội bộ vài người dùng, lượng tài liệu vừa phải và yêu cầu truy vấn chưa cao, cách này giúp kiểm tra chunking, embedding, prompt và trải nghiệm người dùng trước khi đầu tư production.
Tuy nhiên, “dễ bắt đầu” không đồng nghĩa với “mặc định phù hợp cho mọi production”. Khi có nhiều tenant, nhiều collection, tải truy vấn đồng thời, yêu cầu backup/monitoring và chính sách phân quyền chặt, doanh nghiệp cần kiểm thử kỹ kiến trúc Chroma theo phiên bản đang sử dụng hoặc cân nhắc một hệ thống chuyên cho dịch vụ tìm kiếm.
Qdrant là gì?
Qdrant là một vector similarity search engine mã nguồn mở, được thiết kế rõ ràng cho các workload tìm kiếm vector và metadata. Qdrant hỗ trợ collection, payload, filter, distance metric và các cơ chế tối ưu truy vấn phù hợp với hệ thống RAG có xu hướng lớn dần. Có thể chạy Qdrant bằng Docker trên máy chủ riêng, kết nối qua REST hoặc gRPC, và đặt sau reverse proxy khi cần.
Với doanh nghiệp, giá trị của Qdrant không chỉ là tốc độ. Payload filter cho phép truy hồi theo điều kiện như department=sales, document_version=active hoặc customer_id. Đây là nền tảng để tránh trả lời tài liệu sai phòng ban, sai phiên bản hoặc sai tenant. Dù vậy, filter chỉ có ý nghĩa khi pipeline ingest ghi metadata đầy đủ và lớp ứng dụng kiểm tra quyền trước khi truy vấn.
Qdrant cũng đòi hỏi tư duy vận hành nghiêm túc hơn: volume bền vững, backup, giới hạn truy cập, theo dõi dung lượng và kiểm thử nâng cấp. Nó phù hợp khi prototype đã chứng minh nhu cầu và doanh nghiệp muốn một lớp vector service tách biệt khỏi ứng dụng chatbot.
So sánh nhanh Chroma và Qdrant
| Tiêu chí | Chroma | Qdrant |
|---|---|---|
| Mục tiêu khởi đầu | Prototype RAG, notebook, app nhỏ | Vector service cho hệ thống cần mở rộng |
| Độ dễ làm quen | Rất dễ cho đội Python/JavaScript | Cần hiểu collection, payload, filter và vận hành |
| Metadata/filter | Đủ cho nhiều thử nghiệm và use case vừa | Mạnh, phù hợp truy hồi có điều kiện |
| Triển khai | Local hoặc Docker, bắt đầu nhẹ | Docker/self-host, cần chú ý volume và backup |
| Hướng phát triển | Kiểm chứng ý tưởng và pipeline | Production service, nhiều dữ liệu hoặc tenant |
Bảng trên là định hướng, không phải benchmark. Kết quả thực tế phụ thuộc embedding model, độ dài chunk, số vector, index, phần cứng, cache và cách viết truy vấn. Trước khi chốt, hãy đo recall@k, thời gian phản hồi, tỷ lệ câu trả lời có nguồn và chi phí vận hành trên dữ liệu thật.
Khi nào nên chọn Chroma?
- Prototype trong vài ngày: cần trả lời câu hỏi “RAG có giải quyết vấn đề này không?” trước khi xây API đầy đủ.
- Kho tài liệu nhỏ: vài nghìn đến mức vừa phải, ít người dùng đồng thời và chưa cần multi-tenant phức tạp.
- Đội phát triển nhỏ: muốn tập trung vào chunking, embedding, prompt và UX thay vì vận hành database.
- Ứng dụng nội bộ: trợ lý tra cứu SOP, tài liệu sản phẩm hoặc bộ câu hỏi đào tạo.
Chroma đặc biệt hữu ích khi doanh nghiệp muốn làm một bản demo có thể đo được. Đừng đưa dữ liệu nhạy cảm vào máy local cá nhân mà không có quy định. Prototype vẫn cần secret management, phân quyền file và cơ chế xoá dữ liệu thử nghiệm.
Khi nào nên chọn Qdrant?
- RAG đã được dùng thật: chatbot có người dùng thường xuyên và truy hồi là thành phần quan trọng của dịch vụ.
- Cần filter theo metadata: mỗi phòng ban, khách hàng hoặc gói dịch vụ chỉ được xem nguồn phù hợp.
- Nhiều workflow cùng dùng một vector service: website, chatbot CSKH, trợ lý sales và hệ thống tìm kiếm nội bộ.
- Muốn tách lớp dữ liệu: đội vận hành cần backup, monitoring và quy trình triển khai rõ ràng.
Qdrant không tự giải quyết multi-tenancy hay authorization. Hãy coi payload filter là một lớp hỗ trợ, không phải hàng rào bảo mật duy nhất. API gateway, kiểm tra quyền ở application layer và log truy cập vẫn cần thiết.
Kiến trúc self-host tham khảo
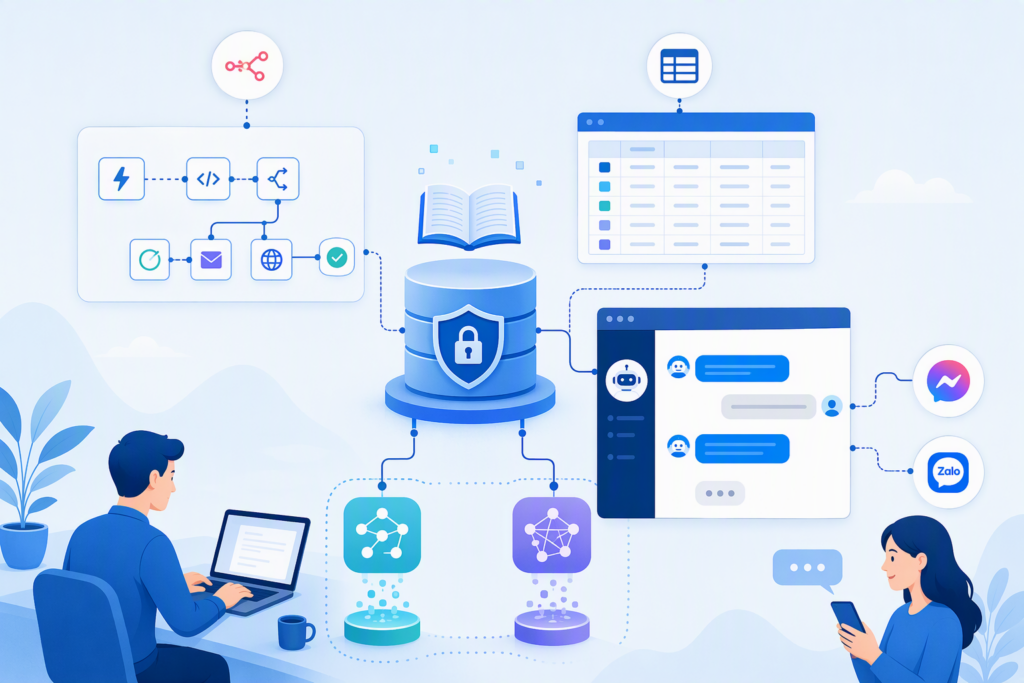
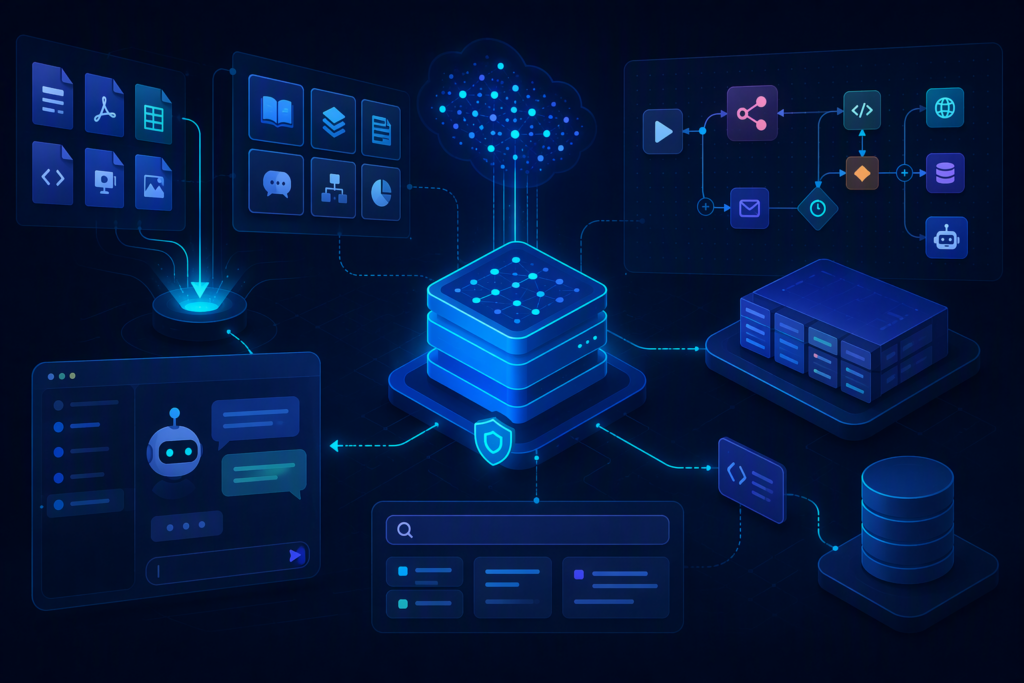
Một kiến trúc khởi đầu có thể gồm WordPress hoặc website làm nơi nhận câu hỏi, một API RAG xử lý xác thực và prompt, Chroma hoặc Qdrant làm vector index, object storage giữ file gốc, NocoDB lưu danh mục tài liệu và n8n điều phối các tác vụ ingest. Với doanh nghiệp Việt Nam, Smax.AI có thể đảm nhận lớp chatbot/kịch bản ở những kênh phù hợp, còn API RAG cung cấp nguồn trả lời có trích dẫn.
Với prototype, một VPS khoảng 2 vCPU và 4 GB RAM có thể đủ để thử nghiệm nhỏ, nhưng đây chỉ là ước lượng tham khảo. Embedding batch, OCR, reranking và nhiều người dùng đồng thời sẽ cần tài nguyên khác. Khi chuyển production, nên tách worker ingest khỏi API truy vấn, đặt volume SSD, sao lưu định kỳ và giới hạn Qdrant/Chroma chỉ nhận kết nối từ mạng nội bộ hoặc reverse proxy có xác thực.
Kết hợp với n8n, NocoDB, WordPress và Smax.AI
- Nhận tài liệu: nhân viên tải SOP, bảng giá hoặc FAQ lên WordPress, object storage hoặc form nội bộ.
- Ghi trạng thái: n8n tạo bản ghi trong NocoDB gồm owner, phòng ban, phiên bản, quyền truy cập và trạng thái
pending. - Tiền xử lý: worker trích xuất text, chia chunk, tạo embedding và upsert vào Chroma hoặc Qdrant. Mỗi vector cần có
document_id,versionvà metadata quyền. - Đánh dấu hoàn tất: n8n cập nhật NocoDB thành
active, lưu số chunk, thời gian index và lỗi nếu có. - Trả lời: website, Smax.AI, Messenger hoặc Zalo gửi câu hỏi đến API RAG. API kiểm tra người dùng, filter nguồn, truy hồi top-k rồi tạo câu trả lời có liên kết về tài liệu.
- Duy trì: khi tài liệu đổi, n8n không chỉ thêm bản mới; nó phải vô hiệu hóa version cũ, re-index và kiểm tra các câu hỏi mẫu.
NocoDB phù hợp làm bảng điều khiển nhẹ cho đội vận hành: tài liệu nào đang chờ duyệt, tài liệu nào lỗi OCR, collection nào cần re-index và câu hỏi nào không tìm thấy nguồn. n8n có thể gửi cảnh báo Telegram khi ingest thất bại hoặc khi tỷ lệ “không tìm thấy tài liệu” tăng bất thường.
Use case cho doanh nghiệp Việt Nam
Trung tâm đào tạo
Học viên hỏi học phí, lịch học và chính sách bảo lưu. RAG trả lời từ tài liệu đã duyệt; NocoDB lưu phiên bản chính sách; sales nhận lead đủ điều kiện qua n8n. Nếu câu hỏi ngoài phạm vi, bot chuyển cho chuyên viên thay vì đoán.
Đội sales B2B
Nhân viên hỏi nhanh bảng giá, điều kiện triển khai và case study. Metadata theo sản phẩm giúp tránh lấy nhầm tài liệu. Khi sales đánh dấu câu hỏi chưa có đáp án, n8n tạo task để content hoặc product bổ sung nguồn.
CSKH sau mua
Website và chatbot tra cứu quy trình bảo hành. NocoDB giữ danh mục phiên bản; vector database chỉ truy hồi tài liệu đang hiệu lực. Các trường hợp cần xác minh đơn hàng được chuyển sang workflow riêng, không để RAG tự quyết định.
Rủi ro cần kiểm soát
RAG có thể trả lời sai dù vector database hoạt động bình thường. Nguyên nhân thường nằm ở chunking kém, embedding không phù hợp tiếng Việt, tài liệu trùng phiên bản, metadata thiếu hoặc prompt không buộc trích dẫn. Doanh nghiệp nên có bộ câu hỏi đánh giá cố định, đo câu trả lời có nguồn, kiểm tra quyền truy cập và ghi lại feedback của người dùng.
Về hạ tầng, không mở cổng database ra Internet nếu không cần; dùng HTTPS ở lớp API, secret riêng cho từng workflow, backup volume và thử khôi phục. Với dữ liệu cá nhân, cần xác định thời hạn lưu trữ và quyền xoá. Self-hosted giúp kiểm soát tốt hơn nhưng không tự động biến hệ thống thành an toàn.
Kết luận: chọn theo giai đoạn, không theo phong trào
Chroma là lựa chọn hợp lý để kiểm chứng pipeline RAG nhanh, nhất là khi đội nhỏ cần tập trung vào chất lượng câu trả lời và trải nghiệm. Qdrant đáng cân nhắc khi hệ thống cần vector service độc lập, filter metadata rõ, nhiều workflow dùng chung hoặc đã bước vào giai đoạn production. Một lộ trình thực tế là prototype bằng Chroma, đo bằng dữ liệu thật, sau đó chuyển sang Qdrant khi yêu cầu vận hành và truy hồi đã rõ — không cần di chuyển chỉ vì chạy theo danh sách công cụ.
Nếu bạn muốn triển khai hệ thống AI automation, chatbot hoặc công cụ AI self-hosted tương tự cho doanh nghiệp, hãy liên hệ Quân Chatbot để được tư vấn giải pháp phù hợp.


Responses