faster-whisper là gì? Tự host chuyển giọng nói thành dữ liệu sales và CSKH
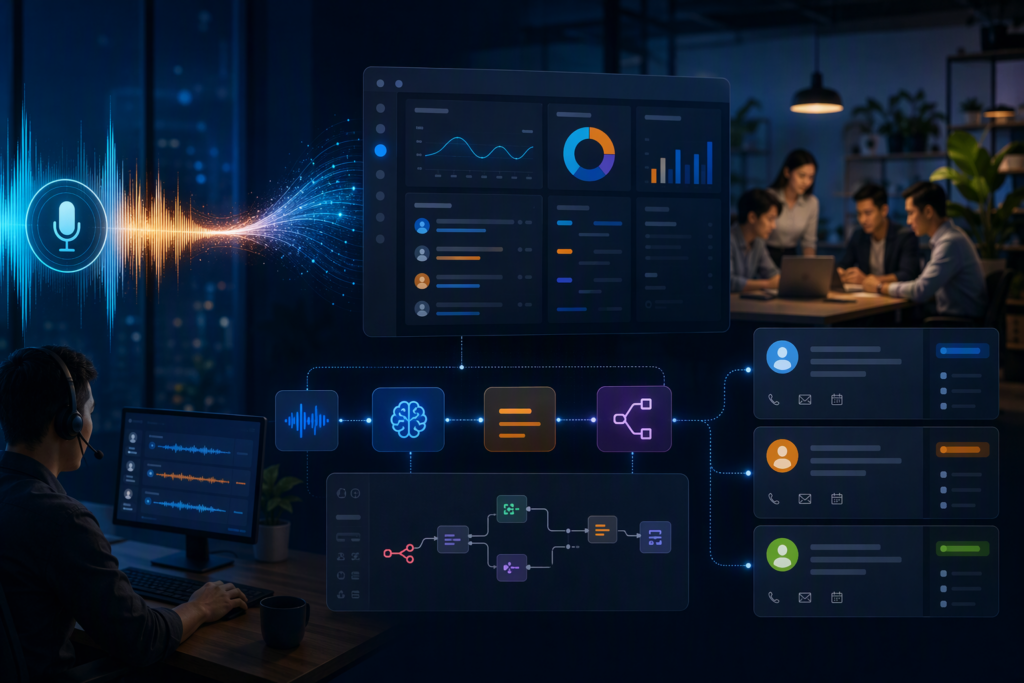
faster-whisper giúp doanh nghiệp tự host nhận diện giọng nói để chép lại cuộc gọi sales, ghi chú tư vấn, phân tích hội thoại CSKH và đưa dữ liệu vào n8n/NocoDB/Smax.AI.
Nhiều doanh nghiệp Việt Nam đang có một “mỏ dữ liệu” rất lớn nhưng gần như không khai thác: cuộc gọi tư vấn, voice Zalo, ghi âm chăm sóc khách hàng, file họp nội bộ, video đào tạo và tin nhắn âm thanh từ khách hàng. Đội sales vẫn phải nghe lại thủ công, ghi chú vội trong CRM, hoặc bỏ qua hoàn toàn vì không đủ thời gian. Kết quả là quản lý không biết cuộc gọi nào có tín hiệu mua hàng, khách thường phản đối điểm gì, nhân viên nào đang xử lý sai kịch bản, và lead nào cần follow-up ngay.
faster-whisper là một lựa chọn đáng chú ý nếu doanh nghiệp muốn tự host bước nhận diện giọng nói, thay vì gửi toàn bộ audio lên dịch vụ bên ngoài. Khi kết hợp với n8n, NocoDB, Smax.AI, WordPress, Zalo, Messenger hoặc website, nó có thể biến âm thanh thành dữ liệu vận hành: transcript, tóm tắt, tag nhu cầu, điểm nóng cần chăm sóc, và log để huấn luyện đội tư vấn.
faster-whisper là gì?
faster-whisper là bản triển khai lại mô hình Whisper bằng CTranslate2, một engine inference tối ưu cho mô hình Transformer. Theo README của dự án, cách triển khai này có thể nhanh hơn OpenAI Whisper tới khoảng 4 lần trong một số cấu hình, dùng ít bộ nhớ hơn, và còn có thể tối ưu thêm bằng 8-bit quantization trên CPU hoặc GPU. Repo chính SYSTRAN/faster-whisper dùng giấy phép MIT, phù hợp để doanh nghiệp tự triển khai trong hệ thống nội bộ nếu tuân thủ điều kiện license.
Nói dễ hiểu: nếu Whisper là “bộ não” chuyển giọng nói thành chữ, faster-whisper là cách chạy bộ não đó nhanh và gọn hơn trong môi trường production. Nó không phải chatbot, không phải CRM, cũng không tự động hiểu quy trình kinh doanh. Giá trị của nó nằm ở bước đầu tiên: biến audio thành văn bản đủ tốt để các workflow AI phía sau xử lý.
Dùng để giải quyết việc gì cho doanh nghiệp?
Với đội sales và CSKH, faster-whisper có thể giúp xử lý các bài toán rất thực tế. Cuộc gọi tư vấn được chép lại để quản lý kiểm tra chất lượng. Voice message của khách được chuyển thành text để chatbot hoặc nhân viên không bỏ sót ý. Buổi họp nội bộ được tóm tắt thành việc cần làm. Video hướng dẫn sản phẩm được tạo transcript để đăng WordPress hoặc đưa vào kho tri thức RAG. Nếu có thêm LLM ở bước sau, hệ thống có thể tự rút ra nhu cầu khách hàng, mức độ nóng của lead, lý do từ chối, câu hỏi thường gặp và hành động tiếp theo.
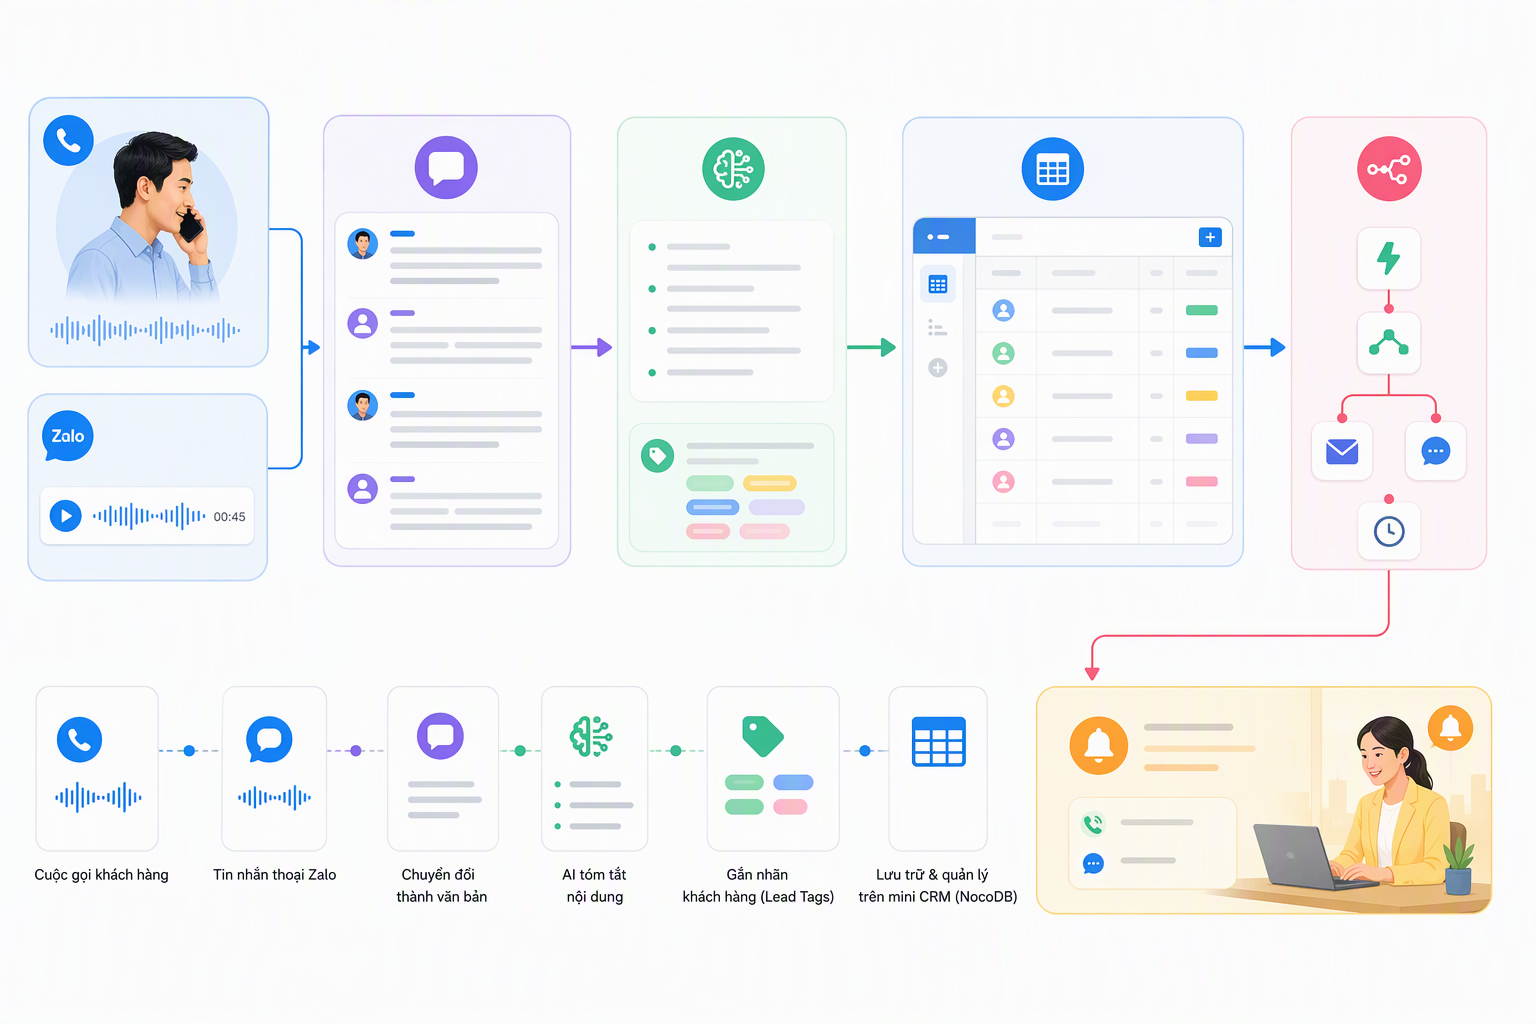
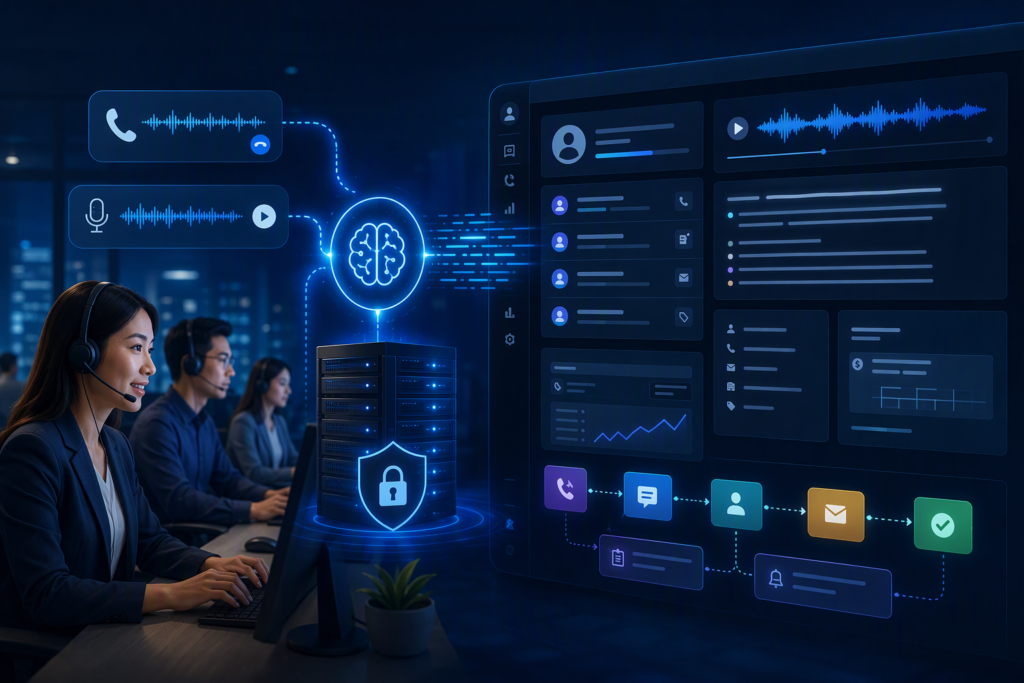
Điểm quan trọng là không nên xem faster-whisper như một công cụ “chép audio cho vui”. Nó nên nằm trong một quy trình dữ liệu. Audio vào hệ thống, transcript được lưu, AI phân tích thành trường có cấu trúc, n8n cập nhật CRM/NocoDB/Smax.AI, rồi nhân viên nhận cảnh báo hoặc task follow-up. Khi đó giọng nói mới trở thành tài sản vận hành.
Ai nên dùng faster-whisper?
Công cụ này phù hợp với doanh nghiệp có nhiều dữ liệu âm thanh nhưng chưa muốn phụ thuộc hoàn toàn vào dịch vụ cloud. Ví dụ: trung tâm đào tạo có nhiều cuộc gọi tư vấn phụ huynh; phòng khám/spa cần kiểm tra chất lượng tư vấn; agency muốn phân tích cuộc gọi sales cho khách hàng; công ty B2B cần tóm tắt meeting; đội CSKH nhận voice từ Zalo/Messenger; hoặc đơn vị có yêu cầu lưu dữ liệu nội bộ vì thông tin khách hàng nhạy cảm.
Ngược lại, nếu mỗi tháng chỉ có vài file audio, không có người vận hành server, và không cần giữ dữ liệu trong hạ tầng riêng, dùng API speech-to-text thương mại có thể nhanh hơn. Self-host chỉ đáng làm khi có nhu cầu về chi phí dài hạn, quyền kiểm soát dữ liệu, tích hợp sâu, hoặc khối lượng xử lý đủ lớn.
Tính năng nổi bật
- Chạy nhanh hơn Whisper gốc trong nhiều cấu hình: nhờ CTranslate2 và khả năng batch/quantization.
- Có thể tự host: chạy trên server riêng, máy nội bộ hoặc VPS/GPU server tùy khối lượng.
- Hỗ trợ CPU và GPU: CPU phù hợp xử lý nhẹ/batch nhỏ; GPU phù hợp audio dài hoặc cần gần realtime.
- Không cần cài FFmpeg hệ thống theo cách dùng phổ biến: audio được decode qua PyAV, giúp đóng gói dễ hơn trong container.
- Dễ bọc thành API nội bộ: có thể viết FastAPI nhận file audio, trả transcript, segment, language và metadata cho n8n.
- Phù hợp pipeline AI: transcript có thể đưa tiếp vào LLM để tóm tắt, phân loại, trích xuất insight.
Kiến trúc self-host cơ bản
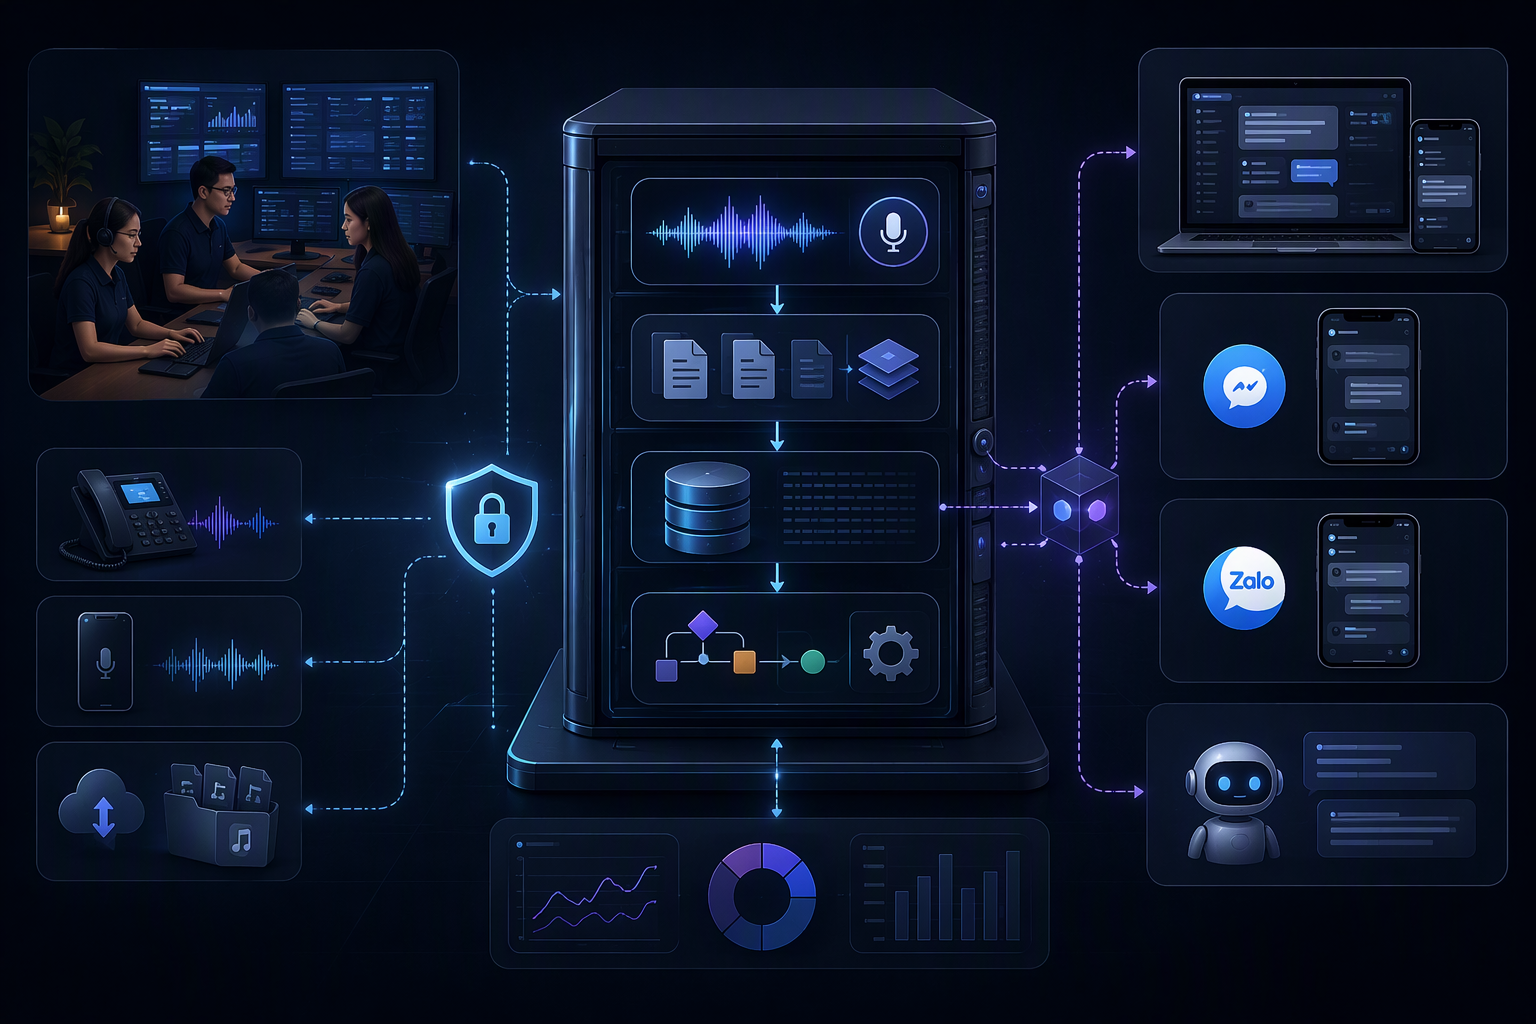
Một kiến trúc gọn cho doanh nghiệp nhỏ có thể gồm 5 lớp. Lớp đầu là nguồn audio: ghi âm tổng đài, voice Zalo/Messenger, file upload từ form website, recording Google Meet/Zoom, hoặc video đào tạo. Lớp thứ hai là API nội bộ chạy faster-whisper, nhận file và trả transcript theo từng đoạn. Lớp thứ ba là n8n để điều phối: lấy audio, gọi API, lưu kết quả, gọi LLM nếu cần. Lớp thứ tư là NocoDB/CRM/Smax.AI để lưu dữ liệu khách hàng và trạng thái chăm sóc. Lớp cuối là kênh hành động: Telegram báo lead nóng, Zalo/Messenger follow-up, WordPress đăng nội dung, hoặc dashboard vận hành.
Với mô hình này, faster-whisper chỉ làm đúng một việc: chuyển âm thanh thành chữ. n8n chịu trách nhiệm retry, log lỗi, phân quyền, lịch chạy và kết nối hệ thống. NocoDB giữ transcript, tóm tắt, tag và trạng thái xử lý. Smax.AI hoặc chatbot website dùng dữ liệu đó để chăm sóc khách hàng theo ngữ cảnh.
Yêu cầu server tham khảo
Yêu cầu tài nguyên phụ thuộc vào model, độ dài audio, số lượng job và kỳ vọng tốc độ. Với nhu cầu thử nghiệm hoặc xử lý vài chục file ngắn mỗi ngày, một VPS CPU 4-8 vCPU, 8-16GB RAM có thể đủ để chạy model nhỏ hoặc medium, chấp nhận tốc độ không realtime. Nếu cần xử lý nhiều cuộc gọi, audio dài, hoặc muốn kết quả gần realtime, nên dùng GPU NVIDIA. README dự án có benchmark trên RTX 3070 Ti 8GB cho các cấu hình large-v2 và distil-whisper-large-v3; đây là thông tin tham khảo, không phải cam kết cho mọi hệ thống.
Doanh nghiệp nên bắt đầu bằng bài test thực tế: lấy 50-100 file audio điển hình, đo thời gian xử lý, RAM/VRAM, độ chính xác tiếng Việt, lỗi tạp âm, và chi phí server mỗi tháng. Đừng chọn server chỉ vì thông số trên mạng; hãy chọn theo khối lượng thật và SLA nội bộ.
Kết hợp với n8n, NocoDB, Smax.AI, WordPress, Zalo/Messenger
Với n8n, bạn có thể tạo workflow: khi có file audio mới trong folder hoặc webhook, gửi sang API faster-whisper, nhận transcript, gọi LLM để tóm tắt, rồi lưu vào NocoDB. Nếu transcript có các tín hiệu như “quan tâm giá”, “hẹn gọi lại”, “đang so sánh đối thủ”, workflow có thể tạo task cho sales hoặc gửi Telegram cho trưởng nhóm.
Với NocoDB, transcript không chỉ là đoạn văn dài. Hãy tách thành các trường: lead_id, source, audio_url, transcript, summary, objection, next_action, sentiment, owner, status, created_at. Cách lưu có cấu trúc giúp lọc cuộc gọi theo chiến dịch, nhân viên, vấn đề khách hỏi và tỷ lệ follow-up.
Với Smax.AI/Zalo/Messenger/website, dữ liệu speech-to-text có thể quay lại kênh hội thoại. Ví dụ khách gửi voice trên Zalo, hệ thống chép lại, AI hiểu ý định, gợi ý câu trả lời cho nhân viên hoặc kích hoạt kịch bản chăm sóc. Với WordPress, transcript video/webinar có thể biến thành bài blog, FAQ, tài liệu onboarding hoặc nguồn dữ liệu cho chatbot hỏi đáp.
Ưu điểm
- Kiểm soát dữ liệu tốt hơn: audio và transcript có thể nằm trong hạ tầng riêng.
- Chi phí dài hạn linh hoạt: khi volume cao, self-host có thể tối ưu hơn trả phí theo phút.
- Dễ tích hợp sâu: tự quyết định format output, log, retry, quyền truy cập và pipeline sau transcript.
- Phù hợp automation: n8n có thể dùng transcript như input cho CRM, chatbot, báo cáo và dashboard.
- Không bị khóa vào một nhà cung cấp duy nhất: có thể thay model, server hoặc lớp phân tích phía sau.
Hạn chế và rủi ro
Self-host không miễn phí hoàn toàn. Bạn cần server, giám sát lỗi, cập nhật dependency, bảo mật file audio, phân quyền truy cập transcript và quy trình xoá dữ liệu khi không còn cần thiết. Độ chính xác tiếng Việt có thể giảm nếu audio nhiều tạp âm, nói chồng, giọng vùng miền khó, điện thoại ghi âm kém hoặc dùng nhiều thuật ngữ chuyên ngành. Nếu dùng GPU, chi phí server và kỹ thuật triển khai CUDA/cuDNN cũng cần tính trước.
Use case cho doanh nghiệp Việt Nam
- Sales call intelligence: chép lại cuộc gọi, trích xuất nhu cầu, lý do từ chối, mức độ nóng và hẹn follow-up.
- CSKH đa kênh: chuyển voice Zalo/Messenger thành text để lưu lịch sử và hỗ trợ nhân viên trả lời nhanh.
- Đào tạo đội tư vấn: lấy transcript cuộc gọi tốt/xấu để tạo thư viện tình huống và checklist coaching.
- Content marketing: biến webinar, livestream, video hướng dẫn thành outline bài blog WordPress và FAQ.
- Kho tri thức nội bộ: lưu transcript họp, training, demo sản phẩm để đưa vào hệ thống RAG hỏi đáp.
- Kiểm soát chất lượng: phát hiện cuộc gọi thiếu bước xác nhận nhu cầu, thiếu thông tin giá, hoặc không chốt next action.
Khi nào nên chọn và không nên chọn?
Nên chọn faster-whisper khi doanh nghiệp có nhiều audio, muốn kiểm soát dữ liệu, có nhu cầu tích hợp vào automation, và chấp nhận đầu tư vận hành server. Đây là lựa chọn tốt cho đội đã có n8n, NocoDB, chatbot hoặc CRM nội bộ và muốn thêm lớp “nghe hiểu” vào hệ thống.
Không nên chọn nếu bạn cần giải pháp hoàn chỉnh chỉ với vài cú nhấp, không có người kỹ thuật, hoặc khối lượng audio quá ít. Trong trường hợp đó, dùng dịch vụ speech-to-text cloud, sau đó nối vào n8n, có thể thực tế hơn. faster-whisper mạnh nhất khi nó là một phần của AI automation stack, không phải một công cụ đơn lẻ.
FAQ
faster-whisper có hỗ trợ tiếng Việt không?
Có thể dùng cho tiếng Việt vì dựa trên họ mô hình Whisper đa ngôn ngữ. Tuy nhiên độ chính xác phụ thuộc chất lượng audio, model, tiếng ồn, giọng nói và từ chuyên ngành. Nên test bằng dữ liệu thật của doanh nghiệp trước khi triển khai rộng.
Có cần GPU không?
Không bắt buộc cho thử nghiệm hoặc batch nhỏ, nhưng GPU hữu ích khi audio dài, số lượng lớn hoặc cần kết quả nhanh. CPU vẫn dùng được nếu chọn model phù hợp và chấp nhận thời gian xử lý lâu hơn.
Có nên lưu toàn bộ audio gốc không?
Nên lưu theo chính sách rõ: thời hạn lưu, quyền truy cập, mục đích sử dụng và thời điểm xoá.
faster-whisper khác gì với chatbot AI?
faster-whisper chuyển giọng nói thành văn bản. Chatbot hoặc LLM phía sau mới dùng văn bản đó để tóm tắt, trả lời, phân loại, tạo task hoặc cập nhật CRM.
Kết luận
faster-whisper là một mảnh ghép quan trọng trong AI automation stack cho doanh nghiệp có nhiều dữ liệu giọng nói. Nó giúp tự host bước speech-to-text, giảm phụ thuộc vào dịch vụ bên ngoài và mở đường cho các workflow phân tích sales/CSKH sâu hơn. Nhưng để tạo giá trị kinh doanh, hãy triển khai nó cùng n8n, NocoDB, Smax.AI, CRM và quy trình hành động rõ ràng. Chuyển audio thành chữ mới chỉ là bước đầu; biến chữ đó thành follow-up, insight và cải thiện vận hành mới là mục tiêu cuối cùng.
Nếu bạn muốn triển khai hệ thống AI automation, chatbot hoặc công cụ AI self-hosted tương tự cho doanh nghiệp, hãy liên hệ Quân Chatbot để được tư vấn giải pháp phù hợp.



Responses