Milvus là gì? Vector database tự host cho RAG quy mô lớn hơn
Khi doanh nghiệp bắt đầu làm chatbot hỏi đáp tài liệu, nhiều đội chọn cách đơn giản: đưa vài file PDF vào một công cụ AI rồi để nhân viên hỏi thử. Cách này đủ cho demo, nhưng khi số lượng tài liệu tăng lên hàng chục nghìn đoạn, nhiều phòng ban cùng dùng, dữ liệu cần phân quyền, và tốc độ trả lời phải ổn định, bài toán không còn là “gắn chatbot vào website” nữa. Lúc đó doanh nghiệp cần nghĩ đến lớp dữ liệu vector bên dưới hệ thống RAG.
Milvus là một vector database open-source được thiết kế cho tìm kiếm vector, semantic search và các ứng dụng AI dùng embedding. Theo tài liệu chính thức, Milvus có thể chạy từ môi trường nhẹ để thử nghiệm đến triển khai standalone bằng Docker và mô hình distributed trên Kubernetes cho dữ liệu rất lớn. Nói dễ hiểu: Milvus là nơi lưu “dấu vân tay ngữ nghĩa” của tài liệu, hội thoại, sản phẩm, hình ảnh hoặc âm thanh để hệ thống AI tìm đúng phần liên quan trước khi trả lời.
1. Vấn đề kinh doanh: chatbot AI càng dùng nhiều càng cần lớp tìm kiếm tốt hơn
Ở giai đoạn đầu, một chatbot tài liệu thường chỉ cần vài chục file: bảng giá, chính sách bảo hành, quy trình tư vấn, tài liệu sản phẩm hoặc kịch bản CSKH. Nhưng khi triển khai thật, dữ liệu bắt đầu phình ra. Mỗi phòng ban có tài liệu riêng. Một file có nhiều phiên bản. Một câu hỏi của khách có thể liên quan đến điều khoản giá, tình trạng tồn kho, hướng dẫn sử dụng và lịch sử chăm sóc.
Nếu chỉ nhét toàn bộ nội dung vào prompt, chi phí cao và câu trả lời dễ nhiễu. Nếu chỉ dùng tìm kiếm từ khoá, hệ thống bỏ lỡ những câu hỏi diễn đạt khác nhau nhưng cùng ý nghĩa. RAG giải quyết bài toán này bằng cách biến tài liệu thành embedding, lưu vào vector database, tìm các đoạn liên quan nhất, rồi đưa vào LLM để trả lời có căn cứ.
Milvus nằm ở phần vector database đó. Nó không thay thế LLM, không thay thế n8n, cũng không phải chatbot builder. Vai trò của Milvus là lưu trữ và tìm kiếm vector ở quy mô lớn, nhanh và có cấu trúc hơn khi hệ thống AI bắt đầu nghiêm túc.
2. Milvus là gì?
Milvus là vector database open-source do Zilliz phát triển, hiện thuộc hệ sinh thái LF AI & Data Foundation. Công cụ này được phân phối theo giấy phép Apache 2.0 và tập trung vào dữ liệu phi cấu trúc như văn bản, hình ảnh, âm thanh hoặc dữ liệu đa phương thức sau khi đã được chuyển thành embedding.
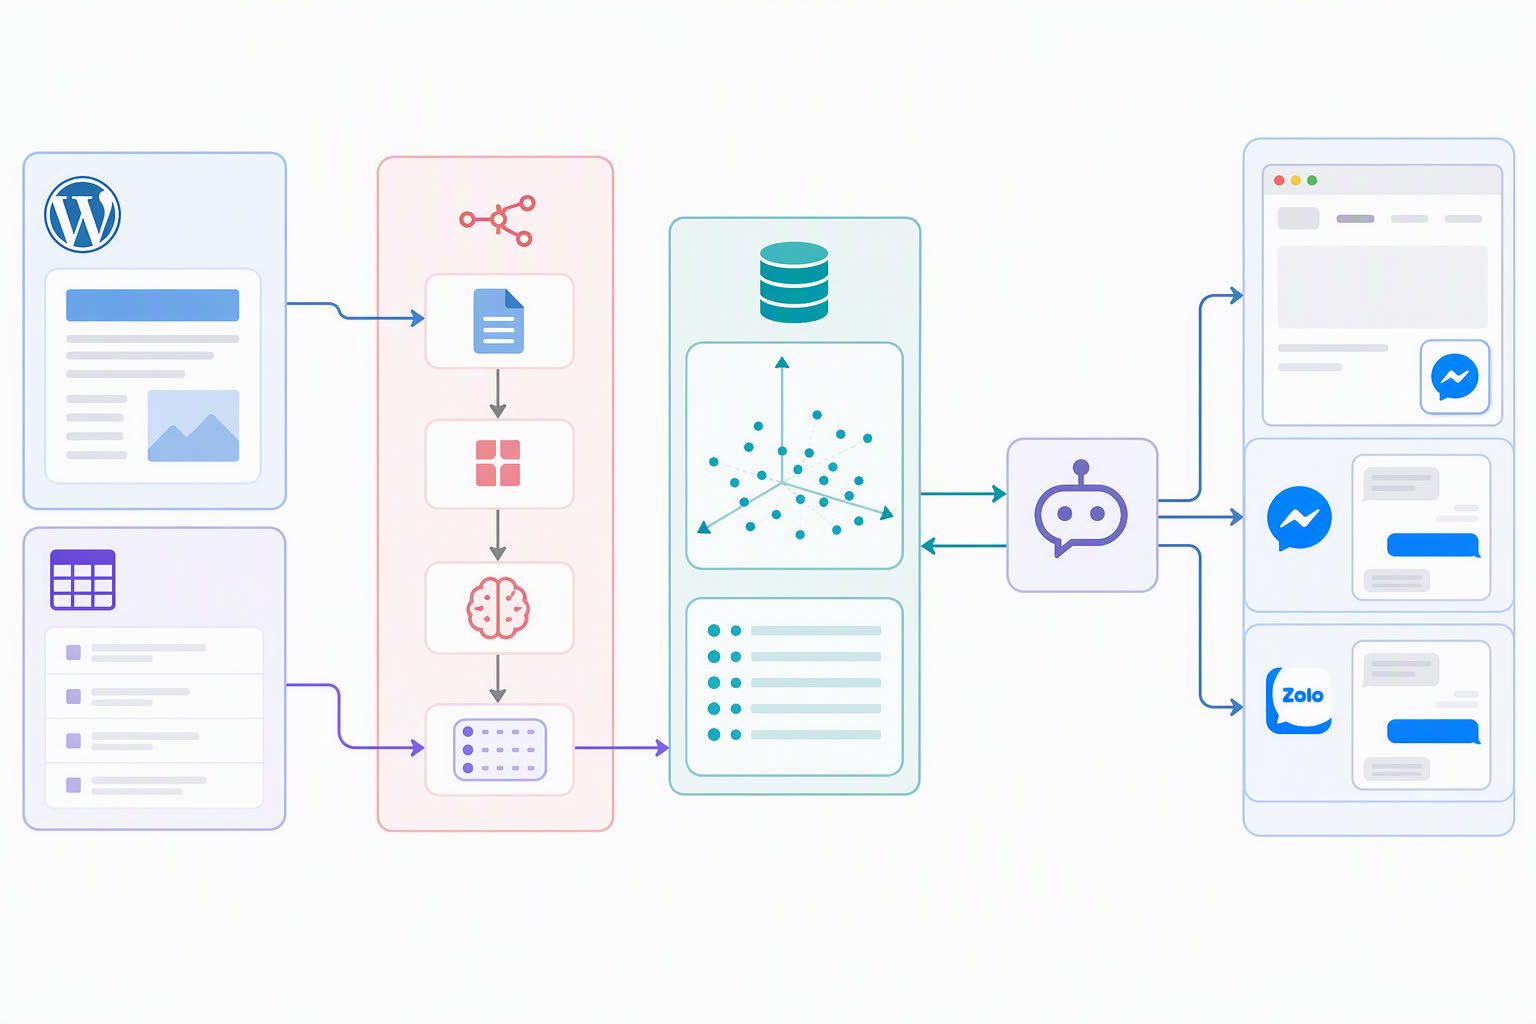
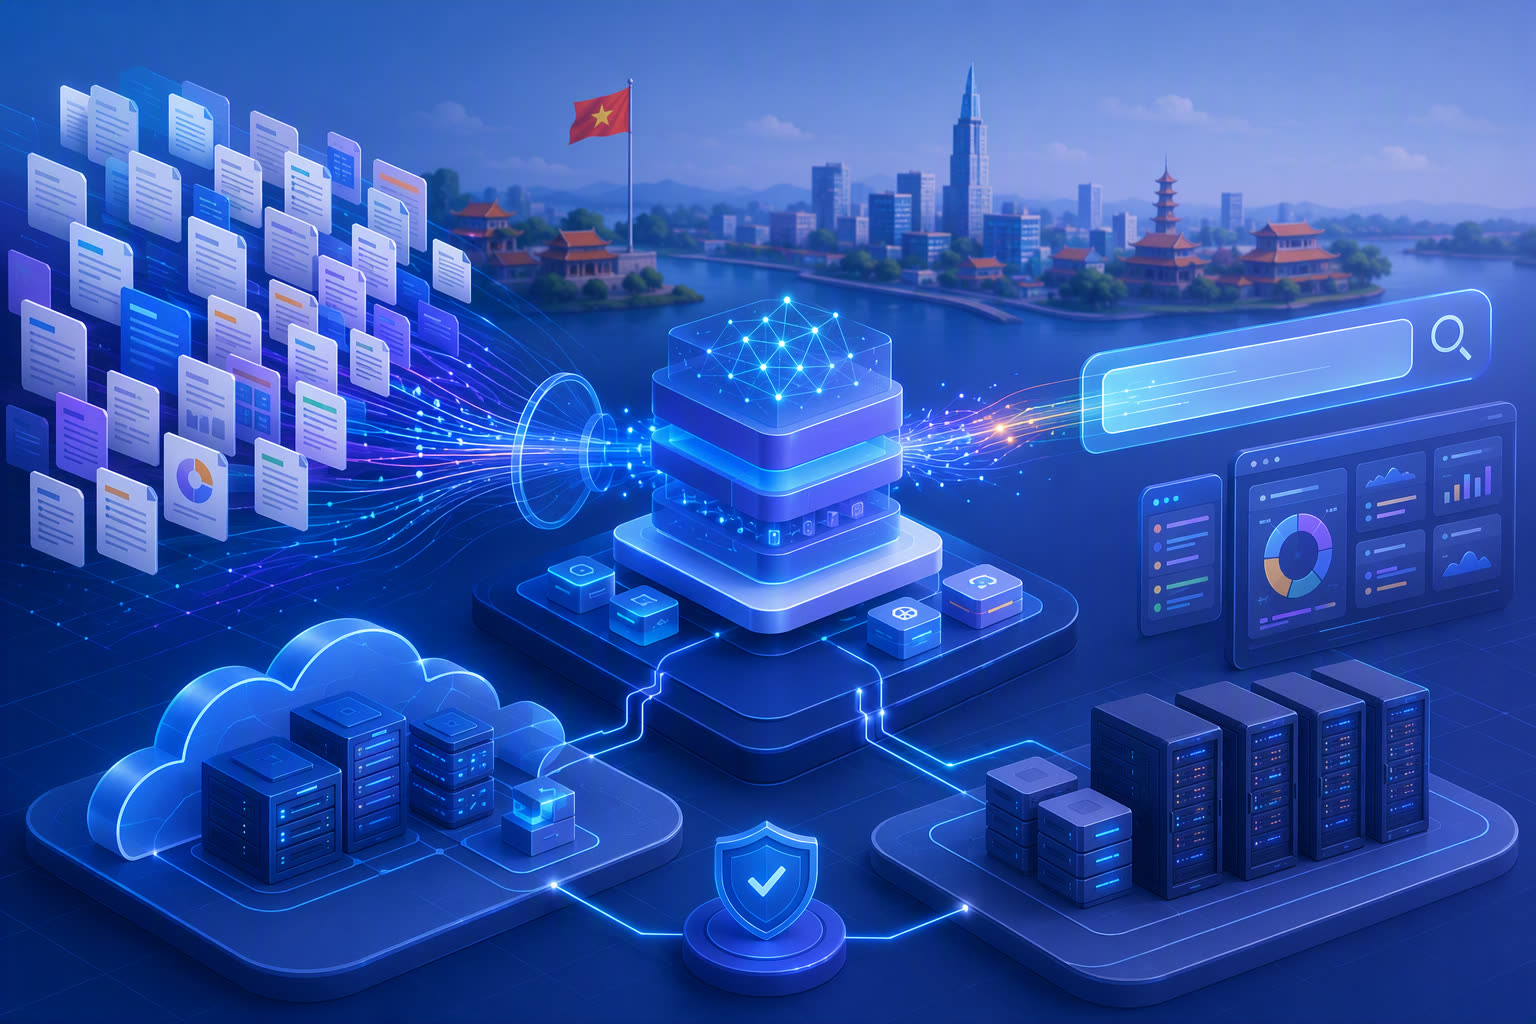
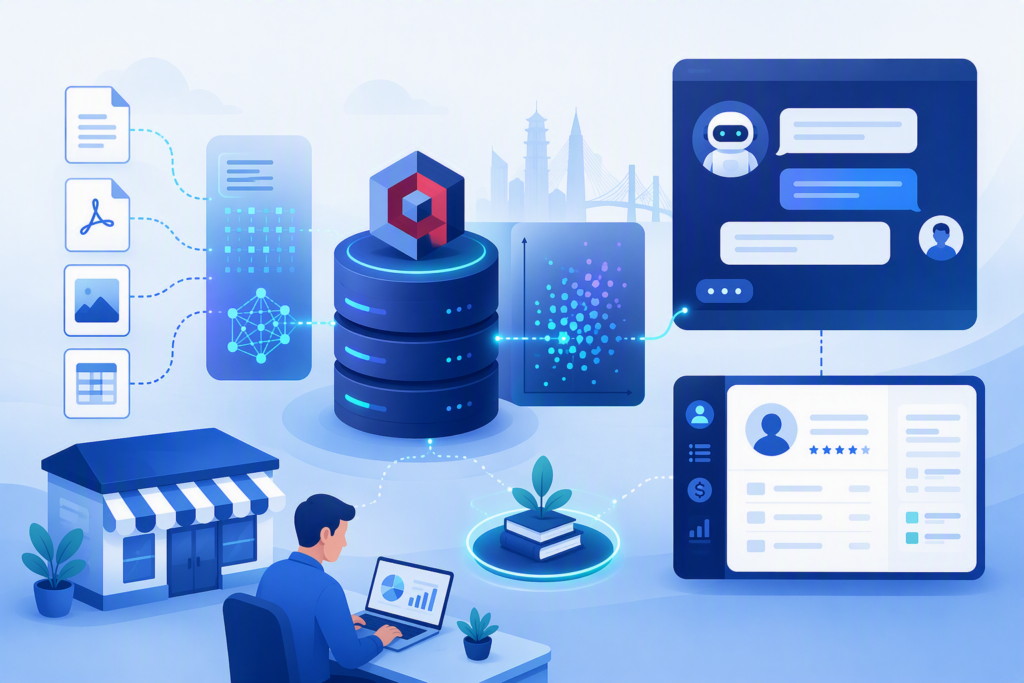
Trong một hệ thống RAG, quy trình thường gồm bốn bước. Một là thu thập tài liệu từ WordPress, Google Drive, CRM, NocoDB, helpdesk hoặc kho file nội bộ. Hai là chia tài liệu thành các đoạn nhỏ đủ ngữ cảnh. Ba là dùng embedding model để chuyển mỗi đoạn thành vector. Bốn là lưu vector, metadata và thông tin nguồn vào Milvus để truy vấn khi người dùng đặt câu hỏi.
Khi có câu hỏi mới, hệ thống cũng chuyển câu hỏi thành vector, tìm trong Milvus các đoạn gần nhất về mặt ngữ nghĩa, lọc theo metadata như phòng ban, ngôn ngữ, sản phẩm hoặc quyền truy cập, rồi đưa kết quả vào LLM. Nhờ vậy, chatbot trả lời dựa trên dữ liệu liên quan thay vì đoán mò.
3. Milvus giúp doanh nghiệp giải quyết việc gì?
Ứng dụng dễ thấy nhất là chatbot hỏi đáp tài liệu. Một công ty có thể đưa chính sách bán hàng, hướng dẫn sử dụng, FAQ, quy trình nội bộ và tài liệu đào tạo vào knowledge base. Nhân viên sales hỏi: “gói này có cam kết bảo hành bao lâu?” hoặc khách hỏi trên website: “mua xong có được hỗ trợ cài đặt không?”. Hệ thống dùng Milvus tìm đoạn tài liệu đúng rồi trả lời qua Smax.AI, livechat website hoặc Messenger.
Ứng dụng thứ hai là semantic search cho sản phẩm và nội dung. Thay vì khách phải nhập đúng tên sản phẩm, họ có thể mô tả nhu cầu: “máy phù hợp cho quán nhỏ, ít nhân viên, cần in bill nhanh”. Hệ thống tìm các sản phẩm hoặc bài tư vấn có ý nghĩa gần nhất.
4. Ai nên dùng Milvus?
Milvus phù hợp với doanh nghiệp hoặc agency automation đã vượt qua giai đoạn thử nghiệm RAG đơn giản. Nếu bạn chỉ có vài file nhỏ và vài người dùng, những công cụ như AnythingLLM, RAGFlow, Dify hoặc một vector store nhẹ có thể đủ. Nhưng nếu dữ liệu tăng nhanh, cần tách collection theo khách hàng, cần tìm kiếm tốc độ cao, hoặc muốn tự chủ lớp hạ tầng vector, Milvus đáng để cân nhắc.
5. Tính năng nổi bật theo góc nhìn triển khai
Điểm mạnh đầu tiên là Milvus được thiết kế cho vector search hiệu năng cao. Tài liệu chính thức nhấn mạnh các tối ưu như search engine bằng C++, kiến trúc hướng cột, nhiều thuật toán index/search như IVF, HNSW, DiskANN, cùng khả năng tối ưu theo phần cứng như SIMD, AVX512, GPU hoặc NVMe SSD tuỳ môi trường.
Điểm mạnh thứ hai là nhiều chế độ triển khai. Milvus Lite phù hợp thử nghiệm nhanh trong Python hoặc notebook. Milvus Standalone chạy một máy bằng Docker, thuận tiện cho server riêng của doanh nghiệp nhỏ hoặc staging. Milvus Distributed chạy trên Kubernetes cho bài toán lớn hơn, cần dự phòng và mở rộng theo cụm.
6. Kiến trúc self-host cơ bản
Một kiến trúc dễ hiểu cho doanh nghiệp nhỏ có thể gồm: WordPress hoặc kho file là nguồn nội dung, n8n làm lớp ETL, embedding model để tạo vector, Milvus làm vector database, NocoDB làm nơi quản lý metadata và trạng thái duyệt, Smax.AI hoặc web chatbot làm kênh hội thoại, cuối cùng là LLM để tạo câu trả lời.
Luồng nạp dữ liệu có thể chạy định kỳ. n8n lấy bài viết WordPress, tài liệu PDF, bảng FAQ hoặc bản ghi trong NocoDB. Workflow chia nội dung thành đoạn nhỏ, tạo embedding, lưu vector vào Milvus và ghi metadata như document_id, source_url, category, owner, last_reviewed_at. Nếu tài liệu bị cập nhật, workflow đánh dấu phiên bản cũ và nạp lại phiên bản mới.
Luồng hỏi đáp chạy theo thời gian thực. Người dùng hỏi trên website, Messenger, Zalo hoặc cổng nội bộ. Smax.AI hoặc ứng dụng web gửi câu hỏi sang backend/n8n. Hệ thống tạo embedding cho câu hỏi, truy vấn Milvus, lọc theo quyền và nguồn, rồi đưa các đoạn liên quan vào prompt cho LLM. Câu trả lời nên kèm nguồn trích dẫn hoặc đường dẫn bài gốc để người dùng kiểm tra.
7. Yêu cầu server/tài nguyên tham khảo
Yêu cầu tài nguyên phụ thuộc rất mạnh vào số vector, kích thước embedding, loại index, tần suất truy vấn và mức độ dự phòng. Với môi trường thử nghiệm hoặc knowledge base nhỏ, bạn có thể bắt đầu bằng Milvus Lite hoặc Milvus Standalone trên một VPS đủ RAM, SSD và Docker. Với dữ liệu nhiều hơn, nên dùng SSD nhanh, RAM dư để cache và tách riêng dịch vụ LLM/embedding khỏi máy chạy Milvus.
Tham khảo thực tế: giai đoạn pilot có thể bắt đầu với 4 vCPU, 8-16 GB RAM và SSD tốt nếu số tài liệu chưa lớn. Khi lên production, cần benchmark bằng dữ liệu thật: số đoạn tài liệu, số truy vấn đồng thời, độ trễ mong muốn và chiến lược backup. Với hàng triệu đến hàng tỷ vector, nên xem xét mô hình distributed/Kubernetes và người vận hành có kinh nghiệm hạ tầng.
8. Kết hợp Milvus với n8n, Smax.AI, WordPress, Zalo và Messenger
n8n phù hợp làm lớp điều phối. Nó kéo dữ liệu từ WordPress, Google Drive, NocoDB, CRM hoặc form; gọi API embedding; ghi dữ liệu vào Milvus; gửi log lỗi về Telegram; và cập nhật trạng thái đồng bộ. Nếu tài liệu nào chưa được duyệt, n8n có thể bỏ qua để tránh chatbot trả lời từ nội dung chưa kiểm tra.
NocoDB nên đóng vai trò bảng quản trị nhẹ. Bạn có thể tạo bảng Documents, Knowledge Sources, Sync Jobs và Answer Feedback. Đội vận hành xem tài liệu nào đã index, tài liệu nào lỗi, ai là chủ sở hữu, lần duyệt gần nhất là khi nào. Khi người dùng báo câu trả lời sai, feedback được ghi về NocoDB để cải thiện nguồn dữ liệu.
Smax.AI giữ vai trò kênh hội thoại và automation chăm sóc khách. Khi khách hỏi trên Messenger hoặc livechat website, Smax.AI có thể chuyển câu hỏi sang backend RAG, nhận câu trả lời đã được kiểm soát, sau đó tiếp tục kịch bản xin số, phân loại nhu cầu hoặc chuyển sales. Với Zalo/Messenger, cần đặc biệt chú ý chính sách gửi tin và tránh spam follow-up ngoài ngữ cảnh.
9. Ưu điểm khi chọn Milvus
Ưu điểm lớn nhất là khả năng mở rộng. Milvus phù hợp khi doanh nghiệp muốn đi xa hơn một chatbot demo. Bạn có thể bắt đầu nhỏ, sau đó nâng kiến trúc khi dữ liệu và số người dùng tăng. Với hệ sinh thái open-source, doanh nghiệp cũng có nhiều lựa chọn hơn trong việc tự host, tích hợp hoặc chuyển đổi hạ tầng.
Ưu điểm thứ hai là tách rõ trách nhiệm. WordPress quản lý nội dung công khai, NocoDB quản lý metadata và vận hành, n8n điều phối workflow, Smax.AI giữ hội thoại, còn Milvus chuyên xử lý vector search. Khi mỗi lớp làm đúng việc, hệ thống dễ bảo trì hơn.
10. Hạn chế và rủi ro
Milvus không phải lựa chọn đơn giản nhất cho người mới. Bạn cần hiểu embedding, chunking, index, metadata filter, backup, monitoring và bảo mật API. Nếu không có người vận hành, một công cụ RAG đóng gói sẵn có thể nhanh hơn trong giai đoạn đầu.
Rủi ro thứ hai là nhầm tưởng vector database sẽ tự làm câu trả lời chính xác. Thực tế, Milvus chỉ giúp tìm đoạn liên quan. Chất lượng cuối cùng còn phụ thuộc tài liệu nguồn, cách chia đoạn, embedding model, prompt, bộ lọc quyền truy cập và quy trình kiểm duyệt. Dữ liệu cũ hoặc sai vẫn tạo ra câu trả lời sai.
11. Khi nào nên chọn và không nên chọn Milvus?
Nên chọn Milvus khi bạn có nhiều tài liệu, cần self-host, muốn kiểm soát hạ tầng, dự kiến mở rộng dữ liệu, hoặc đang xây nền tảng RAG cho nhiều phòng ban/khách hàng. Milvus đặc biệt hợp khi vector search là phần lõi của sản phẩm hoặc quy trình nội bộ.
Chưa nên chọn Milvus nếu bạn chỉ cần chatbot hỏi đáp vài file, chưa có người quản trị server, chưa rõ dữ liệu nguồn, hoặc mục tiêu trước mắt là kiểm chứng nhu cầu kinh doanh. Trong trường hợp đó, hãy bắt đầu bằng một công cụ RAG đóng gói nhanh hơn, chuẩn hoá tài liệu và quy trình feedback trước. Khi có tín hiệu dùng thật, hãy chuyển lớp vector database sang Milvus hoặc một giải pháp tương đương.
FAQ
Có thể dùng Milvus với WordPress không?
Có. n8n có thể đọc bài viết WordPress qua REST API, chia nội dung thành đoạn, tạo embedding và lưu vào Milvus. Chatbot website sau đó truy vấn Milvus để trả lời dựa trên bài viết hoặc tài liệu đã duyệt.
Milvus có phù hợp cho dữ liệu tiếng Việt không?
Có, miễn là bạn chọn embedding model hỗ trợ tiếng Việt tốt và xử lý chunking phù hợp. Vector database không “hiểu tiếng Việt” theo kiểu LLM; chất lượng phụ thuộc nhiều vào embedding và dữ liệu nguồn.
Kết luận
Milvus là lựa chọn đáng chú ý khi doanh nghiệp muốn xây hệ thống RAG hoặc chatbot tài liệu nghiêm túc hơn: dữ liệu nhiều hơn, truy vấn nhanh hơn, cần tự host và cần tách rõ lớp vector search khỏi chatbot/automation. Với n8n làm lớp đồng bộ, NocoDB làm bảng quản trị, Smax.AI làm kênh hội thoại và WordPress/Zalo/Messenger làm điểm chạm khách hàng, Milvus có thể trở thành nền tảng tìm kiếm ngữ nghĩa cho nhiều quy trình AI nội bộ.
Nếu bạn muốn triển khai hệ thống AI automation, chatbot hoặc công cụ AI self-hosted tương tự cho doanh nghiệp, hãy liên hệ Quân Chatbot để được tư vấn giải pháp phù hợp.




Responses